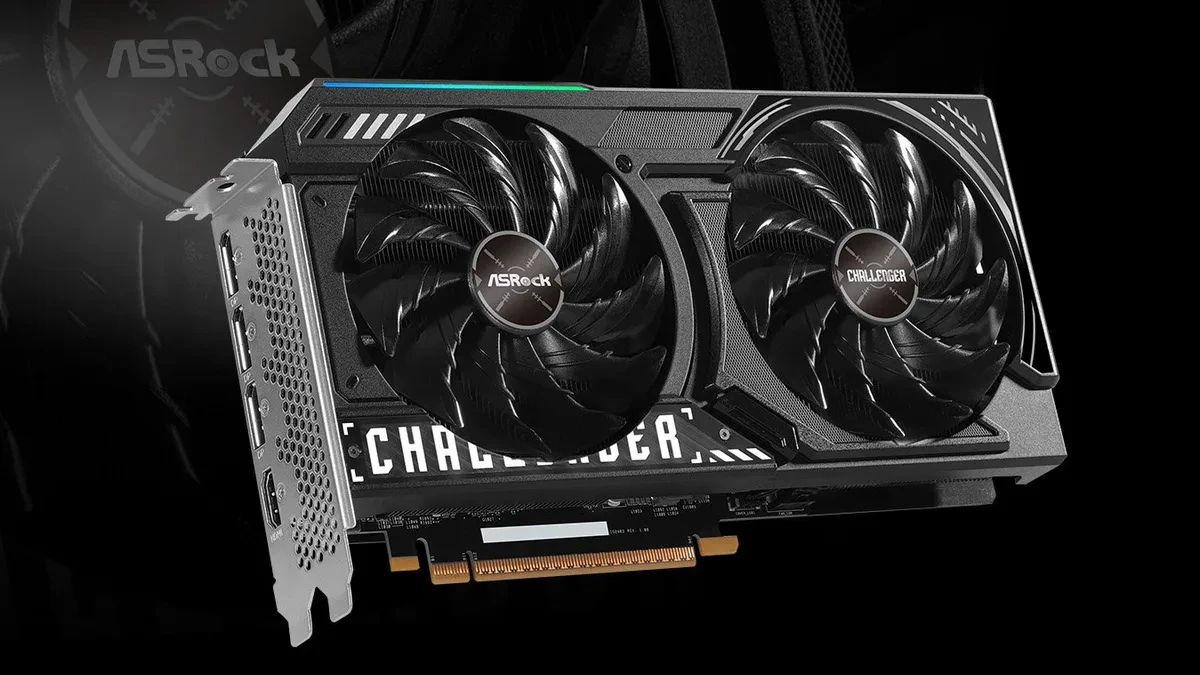
Menjalankan model kecerdasan buatan berukuran 125 miliar parameter (125B) biasanya membutuhkan perangkat keras kelas server dengan memori VRAM jumbo. Namun, pengujian terbaru menunjukkan bahwa efisiensi perangkat lunak mampu mengubah peta kekuatan perangkat keras kelas menengah secara signifikan. Kartu grafis ASRock Intel Arc B580 Challenger 12GB OC terbukti mampu mengeksekusi inferensi AI lokal dengan kecepatan yang jauh lebih tinggi berkat optimasi perangkat lunak yang tepat.
Dalam pengujian yang dipublikasikan oleh media teknologi Jepang PC Watch pada 26 Oktober 2026, penggunaan mesin inferensi XeStrata berhasil mencatatkan kecepatan hingga 31,1 token per detik. Angka ini melonjak tajam dibandingkan saat menggunakan mesin Strata standar yang hanya menghasilkan 10,9 token per detik pada komputer yang sama. Peningkatan ini mencapai sekitar 2,85 kali lipat atau setara 185 persen tanpa mengubah komponen fisik apa pun.
Lonjakan Performa 185 Persen Tanpa Perubahan Perangkat Keras
Pengujian mandiri ini mengevaluasi performa model AI 125B bernama Qwen3.8-Flash-Next. Konfigurasi yang digunakan mencakup kuantisasi IQ3_S, panjang konteks 64K token, serta KV cache 8-bit. Seluruh proses pengujian berjalan di atas sistem operasi Ubuntu 26.04 LTS.
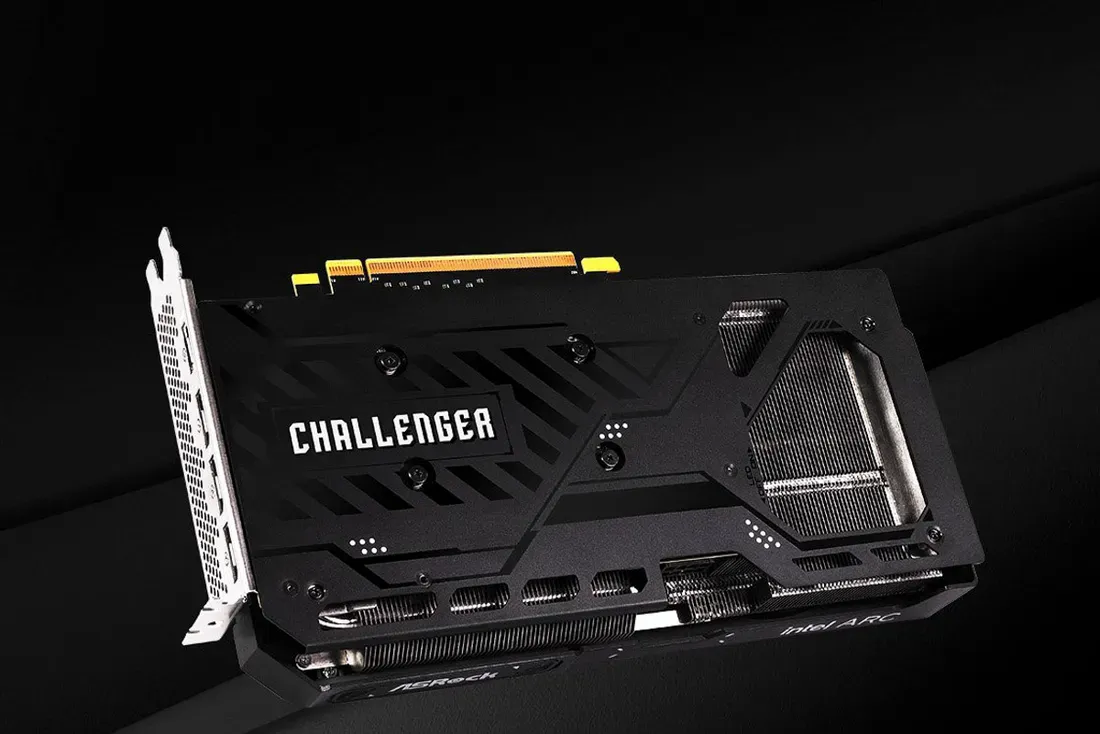
Sistem uji coba tersebut mengawinkan GPU ASRock Intel Arc B580 Challenger 12GB OC dengan prosesor Intel Core Ultra 5 250KF Plus. Kapasitas RAM sistem yang terpasang sebesar 64GB DDR5. Hasilnya sangat mengejutkan. Pengujian membandingkan versi Strata 0.2.1 dengan XeStrata paket 0.1.43-2 (rilis xe0.1.43.1).
Peran Penting Memori GDDR6 12GB dan RAM Sistem 64GB
Kapasitas memori GDDR6 12GB pada kartu grafis tentu tidak akan sanggup menampung keseluruhan bobot data model AI 125B secara mandiri. Perangkat lunak memegang peranan krusial. Arsitektur Strata maupun XeStrata dirancang khusus untuk membagi beban kerja antara VRAM GPU dan RAM sistem secara efisien.
Model dengan kuantisasi IQ3_S membutuhkan alokasi RAM sistem sekitar 50GB. Oleh karena itu, keberadaan RAM 64GB DDR5 pada PC rakitan ini menjadi syarat mutlak, bukan sekadar pelengkap. Penggunaan arsitektur akselerasi matriks Intel XMX pada GPU juga dioptimalkan oleh XeStrata untuk mempercepat jalur eksekusi data.
Menimbang Batasan Teknis dan Efisiensi Perangkat Lunak
Meskipun pencapaian 31,1 token per detik tergolong impresif untuk kelas kartu grafis terjangkau, batasan fisik perangkat keras tetap ada. Pemrosesan pemodelan AI berbasis agent yang kompleks masih membutuhkan kapasitas VRAM yang lebih besar dan bandwidth yang lebih tinggi. Optimasi sistem menjadi kunci utama.
Uji coba ini membuktikan bahwa batas kemampuan pemrosesan AI lokal tidak hanya ditentukan oleh spesifikasi GPU di atas kertas. Pemilihan mesin inferensi yang tepat terbukti mampu mendongkrak performa generasi teks secara drastis pada perangkat keras yang sama. Kartu grafis ini terbukti efisien.