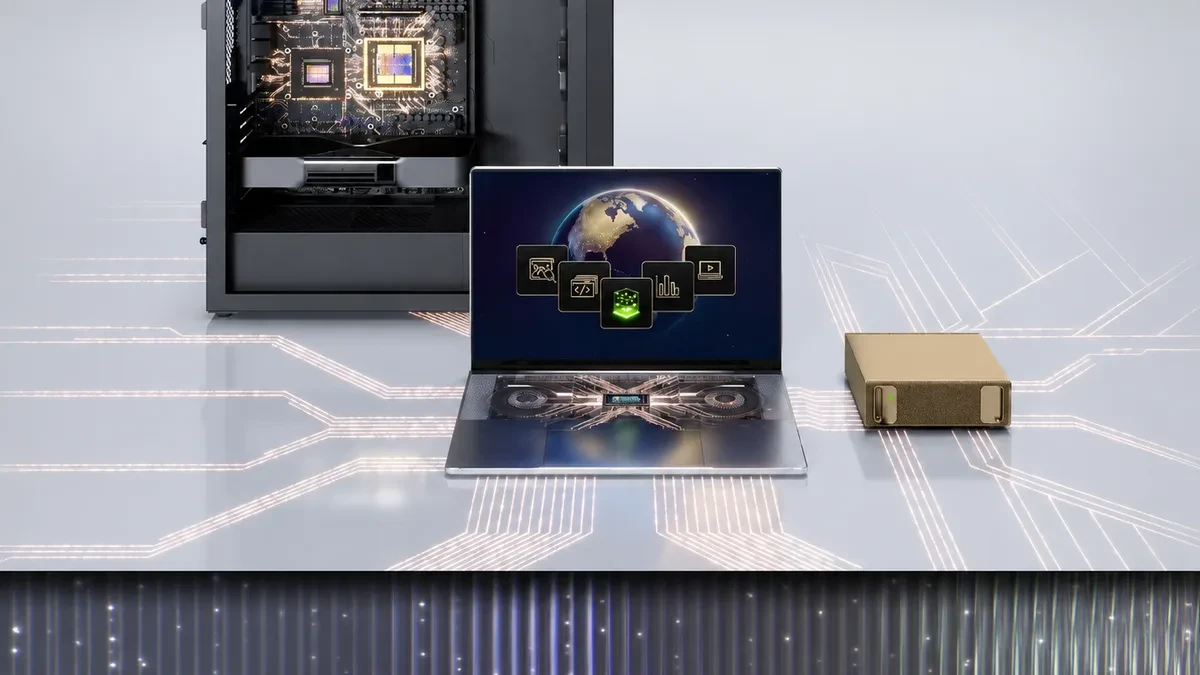
Nvidia resmi memperluas kemampuan kluster pada sasis mini PC AI terbarunya, Nvidia DGX Spark, dalam gelaran GTC Berlin. Melalui pembaruan ini, pengguna kini dapat menghubungkan hingga delapan unit DGX Spark sekaligus untuk mengendalikan total unified memory raksasa hingga 1 TB dalam satu ekosistem komputasi terpadu.
Langkah ini menjadi jawaban Nvidia terhadap kebutuhan inferensi model AI kelas frontier yang kian haus akan kapasitas VRAM. Model besar seperti GLM 5.3 menuntut ruang memori yang sangat lapang agar mampu memproses context window yang panjang serta menjalankan banyak agentic AI secara bersamaan. Varian DGX Spark dengan kapasitas 64 GB yang mengusung superchip Grace Blackwell GB10 dijadwalkan meluncur pada 23 Oktober dengan harga mulai Rp88,5 jutaan ($4,999).
Arsitektur Kluster 8 Unit dan Interkoneksi ConnectX-7
Skalabilitas memori pada sasis ringkas ini menjadi keunggulan teknis yang sangat menarik. Setiap unit Nvidia DGX Spark varian 128 GB yang digabungkan sebanyak delapan sistem akan membentuk total unified memory sebesar 1 TB. Sementara itu, jika pengguna memilih kluster berisi delapan unit varian 64 GB, total memori terpadu yang didapatkan mencapai 512 GB.
Langkah ini sangat krusial. Seluruh unit di dalam kluster saling berkomunikasi melalui modul jaringan terintegrasi ConnectX-7 bawaan pabrik. Namun, saat ini proses penggabungan delapan sistem masih memerlukan konfigurasi manual secara mandiri. Sektor jaringan jadi kunci.
Untuk mempermudah integrasi, Nvidia berjanji merilis pembaruan pada perkakas Nvidia Sync akhir bulan ini. Pembaruan tersebut akan menghadirkan dukungan otomatisasi kluster delapan sistem serta fitur Model Launcher. Fitur baru ini dirancang untuk menyederhanakan proses pengunduhan model AI yang kompatibel, mendistribusikannya ke seluruh jaringan sistem yang terhubung, dan memfasilitasi akses langsung dari alat bantu pemrograman seperti OpenCode.
Optimalisasi Inferensi Perangkat Lunak dan Ekosistem Lokal
Selain peningkatan pada sektor perangkat keras, Nvidia juga menghadirkan perbaikan signifikan pada sisi perangkat lunak. Hasil kolaborasi bersama komunitas pengembang terbuka seperti llama.cpp dan vLLM membuahkan peningkatan kecepatan inferensi yang terasa signifikan pada berbagai skenario komputasi AI.
Pada kartu grafis kelas workstation RTX PRO 6000 Blackwell, pemrosesan tugas agentic AI menggunakan model Qwen 3.8 Flash Next tercatat hingga 40% lebih cepat. Peningkatan ini didorong oleh optimalisasi teknik speculative decoding. Sementara itu, sasis mini PC DGX Spark sendiri mencatatkan akselerasi performa hingga 30% saat menjalankan model Qwen3.8 27B, dan perangkat DGX Station meraih throughput hingga 20% lebih tinggi pada pemrosesan model GLM 5.3 Flash.
Guna memaksimalkan efisiensi kapasitas memori lokal, Nvidia turut memperkenalkan lini checkpoint model AI teroptimasi berbasis format presisi rendah. Model presisi FP4 seperti Qwen3.8 Flash Next FP4 dan GLM 5.3 Flash FP4 didesain khusus untuk menekan konsumsi VRAM. Pemangkasan jejak memori ini secara langsung memberikan ruang yang lebih lega bagi alokasi KV cache, parameter yang amat vital dalam menjaga stabilitas pemrosesan prompt bernarasi panjang.
Evaluasi Efisiensi Skalabilitas dan Catatan Nilai Ekonomis
Klaim peningkatan kecepatan dari Nvidia ini patut dicermati secara kritis. Angka-angka akselerasi yang dipamerkan merupakan hasil pengujian pada skenario beban kerja dan model AI spesifik, bukan peningkatan performa secara menyeluruh untuk semua beban kerja komputasi.
Nvidia belum menyertakan data benchmark rasio skalabilitas resmi saat delapan sistem DGX Spark bekerja bersamaan secara penuh. Data performa kluster masih absen. Di atas kertas, pemrosesan paralel melintasi delapan sasis melalui antarmuka jaringan ConnectX-7 berpotensi menghadapi latency overhead jika dibandingkan dengan arsitektur monolitik dalam satu sasis server besar.
Catatan menarik lainnya terletak pada penetapan harga resmi. Varian 64 GB dari DGX Spark dilepas ke pasar dengan banderol Rp88,5 jutaan ($4,999). Nilai ini terbilang unik karena merupakan angka penjualan yang sebelumnya sempat disandang oleh varian 128 GB. Kendati demikian, bagi praktisi AI yang membutuhkan ruang VRAM besar dalam wujud sasis meja yang praktis, kemampuan penggabungan kluster 8 unit ini memberikan opsi ekspansi komputasi lokal yang fleksibel tanpa harus langsung berinvestasi pada rak server data center.